Дізнайтеся, як опанувати Hash (hashmap) у Ruby, щоб писати чистіший, швидший і більш масштабований код. Стаття охоплює внутрішній устрій, ідіоматичні прийоми й практичні рецепти для щоденних задач.
January 30, 2026 (8mo ago) — last updated September 2, 2026 (1mo ago)
Hashmap у Ruby: чистий та масштабований код
Опануйте Hash (hashmap) у Ruby: внутрішній устрій, найкращі практики, поширені помилки та корисні рецепти для чистого й швидкого коду.
← Back to blog
Опановування Hash у Ruby для чистого та масштабованого коду
Вступ
Дізнайтеся, як опанувати Hash (hashmap) у Ruby, щоб писати чистіший, швидший і більш масштабований код. У цій статті розглядаємо внутрішній устрій, реальні патерни використання, підводні камені й рецепти для повсякденних задач.
Чому опанування Hash змінює ваш підхід до кодування
Ruby Hash — це колекція унікальних ключів і відповідних їм значень. Уявіть його як словник: шукаєте слово (ключ), щоб знайти визначення (значення). Хеші часто застосовують для збереження даних сесії, конфігурацій та тимчасових індексів через швидкі операції вставки й пошуку, які в середньому працюють за константний час1.
Опанування Hash — це не лише синтаксис. Це підхід до структурування логіки: замість довгих if/else або case часто достатньо звернутися до таблиці пошуку, що зменшує складність і підвищує читабельність.
Цей посібник пояснює, як працює Hash в Ruby, ідіоматичні прийоми, типові помилки, практичні рецепти та альтернативи, коли Hash не найкращий вибір.
Як Hash у Ruby працює під капотом
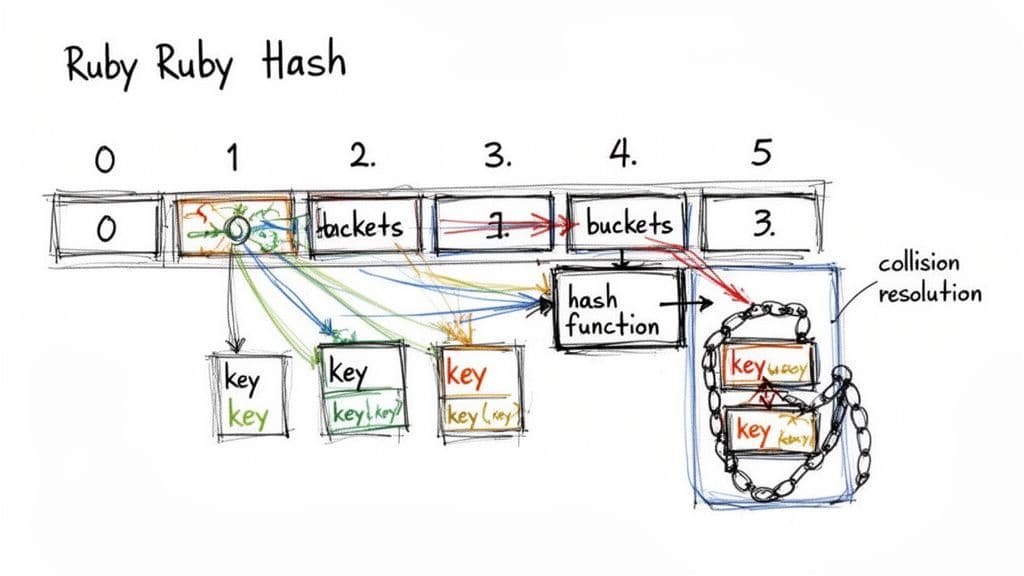
Ruby Hash — це оптимізована хеш-таблиця, реалізована на C. Коли ви додаєте пару ключ–значення, Ruby обчислює хеш-код ключа й відображає його на індекс внутрішнього масиву-«бакета», що дозволяє переходити до потрібної комірки без послідовного перебору1.
Хеш-функція, бакети та колізії
Колізії—коли різні ключі мапляться на один індекс—випадкові й очікувані. Ruby зберігає кілька записів у бакеті й при потребі сканує невеликий перелік. Останні оптимізації ядра Ruby поліпшили локальність даних і поведінку при зміні розміру, що знизило витрати на кеш-промахи в типовому навантаженні й прискорило операції з хешами у реальних додатках2.
Ідіоматичне використання Hash і поширені підводні камені
Теорія корисна, але в продакшені треба уникати тонких багів і писати передбачуваний код.
Символи проти рядків як ключі
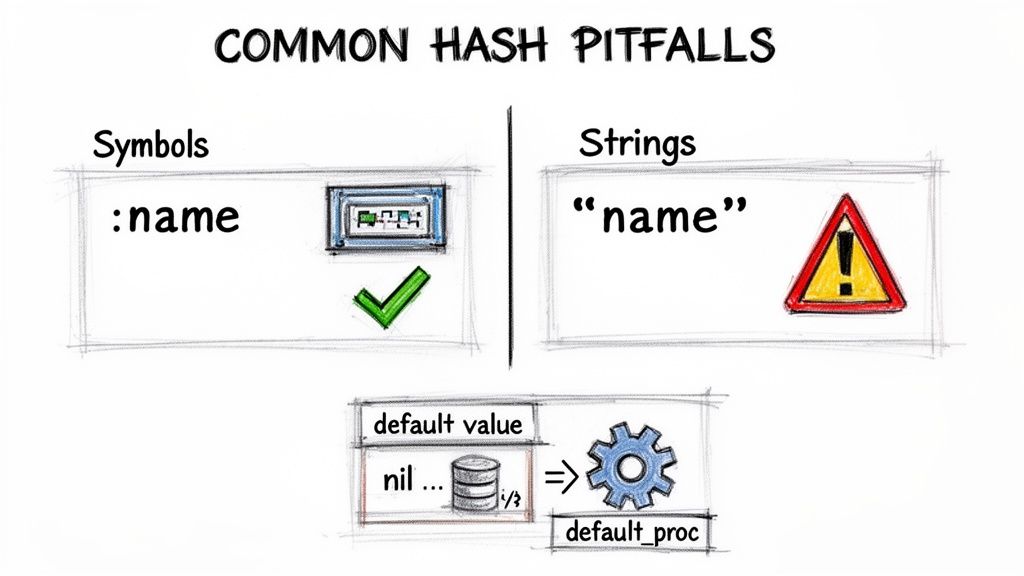
Символ є незмінним і повторно використовується системою, тоді як рядок створює новий об'єкт щоразу. Через це символи здебільшого економніші по пам'яті й швидші для порівнянь, якщо ви впевнені в конвенціях ключів. Часто виникає плутанина між Symbol і String-ключами (наприклад, у params). Нормалізуйте вхідні дані за допомогою symbolize_keys або stringify_keys, щоб уникнути неочікуваних помилок3.
Значення за замовчуванням і default procs
Звернення до неіснуючого ключа повертає nil, що може спричинити NoMethodError. Використовуйте значення за замовчуванням або default proc:
# Безпечне значення за замовчуванням
fruit_counts = Hash.new(0)
fruit_counts[:apple] = 5
fruit_counts[:orange] # => 0
Default proc дозволяє ініціалізувати вкладені структури «ліниво».
merge vs merge!
merge повертає новий Hash, тоді як merge! змінює існуючий. Віддавайте перевагу недеструктивним методам, коли хочете уникнути побічних ефектів і зберегти передбачуваність потоку даних.
Заморожування для незмінності
Для констант і конфігурацій викликайте .freeze, аби запобігти випадковим зміненням:
CONFIG = { api_key: "abc-123", timeout: 5000 }.freeze
# CONFIG[:timeout] = 3000 # raises FrozenError
Практична книга рецептів для Ruby Hash
Цей розділ—добірка рецептів для типових задач.
Ітерація та трансформація
Використовуйте each для ітерації і select, reject, map + to_h для чистого фільтрування й трансформації:
user_permissions = { admin: true, editor: true, viewer: false }
active_roles = user_permissions.select { |role, has_access| has_access }
role_descriptions = user_permissions.map { |role, has_access| [role, "Can perform #{role} actions: #{has_access}"] }.to_h
Безпечна навігація вкладених даних за допомогою dig
dig запобігає NoMethodError при проходженні вкладених хешів:
api_response = { user: { profile: { name: "Alice" } } }
email = api_response.dig(:user, :profile, :email) # => nil
name  = api_response.dig(:user, :profile, :name)  # => "Alice"
Очищення і трансформація ключів/значень
compact, transform_keys і transform_values роблять перетворення коротким і читабельним:
messy_data = { "firstName" => "bob", "lastName" => "smith", "age" => 30 }
clean_data = messy_data
  .transform_keys(&:to_sym)
  .transform_values { |v| v.is_a?(String) ? v.capitalize : v }
# => { :firstName => "Bob", :lastName => "Smith", :age => 30 }
Вибір правильного інструменту
Hash гнучкий, але не завжди оптимальний. Для фіксованих схем використовуйте Struct; для доступу через крапку при непередбачуваних ключах можна застосувати OpenStruct (з урахуванням витрат на продуктивність); для перевірки унікальності — Set з stdlib4.
Правильний вибір структури зменшує пам’ять, підвищує швидкодію й спрощує підтримку.
Швидке порівняння
| Structure | Best for | Advantage | Consideration |
|---|---|---|---|
| Hash | Динамічні key-value дані | Максимальна гнучкість | Більше пам’яті; ризик помилок у ключах |
| Struct | Невеликий набір фіксованих полів | Ефективність по пам’яті; методи | Менш гнучкий |
| OpenStruct | Прототипування, непередбачувані ключі | Зручність через крапку | Повільніший; більше пам’яті |
| Set | Перевірка унікальності | O(1) для перевірки членства | Без значень |
Рефакторинг з використанням патернів Hash
Хеші чудово замінюють довгі if/elsif або case-ланцюги. Замість логіки в коді перенесіть дані у таблицю пошуку — так легше додавати нові випадки:
ENDPOINTS = {
  development: "http://dev.api.example.com",
  staging: "http://staging.api.example.com",
  production: "https://api.example.com"
}.freeze

def get_api_endpoint(environment)
  ENDPOINTS.fetch(environment, "http://localhost:3000")
end
Hash з опціями спрощує сигнатуру методу, упаковуючи необов’язкові параметри в один аргумент.
Часті запитання
Чи Ruby Hash те саме, що hashmap?
Так. hashmap—це загальний термін; у Ruby клас називається Hash і реалізує хеш-таблицю з типовою асимптотикою часу для цих операцій1.
Яку помилку найчастіше слід уникати при роботі з Hash?
Найпоширеніша помилка—змішування ключів у вигляді Symbol і String. Встановіть конвенцію (зазвичай Symbol для внутрішніх ключів) і нормалізуйте зовнішній ввід.
Як Hash впливає на продуктивність у Rails?
Хеші використовуються всюди у Rails: params, сесії, JSON-процеси. Неефективне створення хешів і часті копії можуть призвести до збільшення пам’яті й уповільнення запитів. Профілюйте гарячі точки і віддавайте перевагу операціям на місці або лінивим ініціалізаціям, коли це доцільно2.
Короткі Q&A (звернення до болів розробників)
Q: Як уникнути помилок nil при доступі до вкладених ключів?
A: Використовуйте dig або задавайте безпечні значення за замовчуванням через Hash.new(default) або default proc.
Q: Коли переходити від Hash до Struct або Set?
A: Використовуйте Struct, коли поля фіксовані; Set — коли потрібна лише унікальність і швидкі перевірки членства4.
Q: Як безпечно зливати конфігурації з різних джерел?
A: Віддавайте перевагу недеструктивному merge, заморожуйте фінальний результат і документуйте випадки, коли використовуєте merge!.
У Clean Code Guy наша місія — допомагати командам перетворювати складні кодові бази на активи, які легко підтримувати й масштабувати. Ми глибоко занурюємося в принципи, що допомагають випускати кращий софт швидше. Дізнайтеся, як ми можемо допомогти вам побудувати надійний додаток, готовий до AI, на cleancodeguy.com.
1.
Wikipedia, “Hash table.” https://en.wikipedia.org/wiki/Hash_table
2.
Ruby Issue Tracker, “Hash improvements (power-of-two, data locality).” https://bugs.ruby-lang.org/issues/12142
3.
Ruby Guides, “Symbols in Ruby.” https://www.rubyguides.com/2019/03/ruby-symbols/
4.
Ruby Standard Library, Set. https://ruby-doc.org/stdlib-2.7.0/libdoc/set/rdoc/Set.html
🙋🏻♂️
ШІ пише код.Ви робите його довговічним.
В епоху прискорення ШІ чистий код — це не просто хороша практика — це різниця між системами, які масштабуються, та кодовими базами, які руйнуються під власною вагою.