Hash в Ruby — это базовая структура данных для пар ключ–значение. В этом руководстве вы быстро поймёте, как Hash работает внутри, какие практики применять для чистого кода и как избежать распространённых ошибок.
January 30, 2026 (7mo ago) — last updated August 18, 2026 (19d ago)
Hash в Ruby: чистый и масштабируемый код
Практическое руководство по Hash в Ruby: внутренняя реализация, производительность и лучшие практики для чистого, быстрого и масштабируемого кода.
← Back to blog
Hash в Ruby: чистый и масштабируемый код
Узнайте, как правильно использовать Hash в Ruby — внутренности, производительность и практические приёмы для чистого, быстрого и масштабируемого кода.
Введение
Hash в Ruby — это базовая структура данных для хранения пар ключ–значение. Хорошее владение Hash помогает писать более простые и предсказуемые программы: уменьшить количество условных операторов, улучшить читаемость и упростить поддержку кода. В этом руководстве мы разберём внутреннюю реализацию, идиоматичные приёмы, практические рецепты и типичные ошибки, которых стоит избегать.
Как работает Hash в Ruby «под капотом»
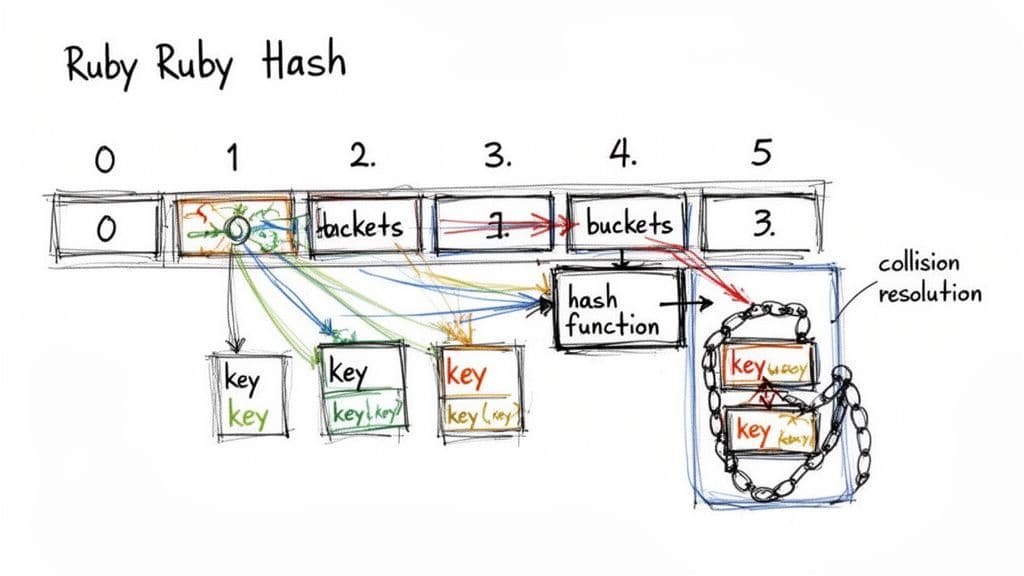
Ruby реализует Hash как хеш-таблицу на C. При добавлении пары ключ–значение ключ проходит через хеш-функцию и попадает в бакет внутреннего массива, что позволяет быстрый доступ без последовательного перебора элементов — амортизированное время операций вставки и поиска близко к O(1)1.
Внутренняя реализация включает обработку коллизий и динамическое изменение размера таблицы. Начиная с Ruby 2.4 были внесены оптимизации, которые улучшили локальность данных и скорость типичных операций с Hash2.
Ключевые понятия
- Хеш‑код и бакет. Ключ сводится к числу, которое маппится в индекс бакета. Коллизии — нормальное явление; Ruby организует единичные списки в бакете и держит их короткими для скорости.
- Амортизированная сложность. Операции поиска и вставки обычно ведут себя как O(1), но редкое перераспределение может быть дороже1.
Идиоматичное использование Hash и распространённые подводные камни
Знать теорию — важно, но гораздо ценнее писать предсказуемый и надёжный код.
Символы vs строки как ключи
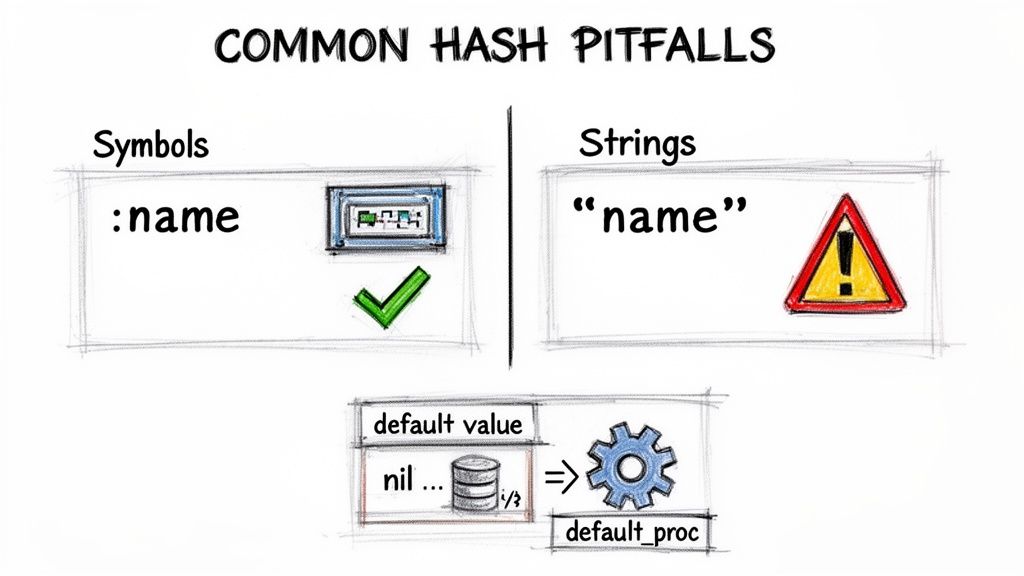
Символы (Symbol) неизменяемы и переиспользуются в памяти, тогда как строки создают новые объекты при каждом создании. Поэтому символы часто экономичнее и быстрее в качестве ключей. Частая ошибка — смешивать Symbol и String и ожидать единообразия; нормализуйте входящие данные как можно раньше с помощью symbolize_keys или stringify_keys.3
Значение по умолчанию и proc по умолчанию
По умолчанию обращение к несуществующему ключу возвращает nil, что может привести к NoMethodError. Для безопасной работы используйте значения по умолчанию или proc:
# Значение по умолчанию
counts = Hash.new(0)
counts["apple"] = 5
counts["orange"] # => 0

# Proc по умолчанию для ленивой инициализации
groups = Hash.new { |h, k| h[k] = [] }
groups[:users] << "alice"
Merge vs merge!
merge возвращает новый Hash, merge! мутирует существующий. Предпочитайте недеструктивные методы там, где важно избежать побочных эффектов и сохранить предсказуемость.
Freeze для неизменяемости
Если конфигурация не должна меняться, вызовите .freeze, чтобы предотвратить случайные мутации:
CONFIG = { api_key: "abc-123", timeout: 5000 }.freeze
# CONFIG[:timeout] = 3000 # => raises FrozenError
Практические рецепты
Итерация и трансформация
Используйте встроенные методы коллекций для лаконичного кода:
user_permissions = { admin: true, editor: true, viewer: false }
active_roles = user_permissions.select { |role, has_access| has_access }
role_descriptions = user_permissions.map { |role, has_access| [role, "Can perform #{role} actions: #{has_access}"] }.to_h
Безопасная навигация по вложенным данным с dig
dig предотвращает ошибки при обходе вложенных хэшей:
api_response = { user: { profile: { name: "Alice" } } }
email = api_response.dig(:user, :profile, :email) # => nil
name  = api_response.dig(:user, :profile, :name)  # => "Alice"
Очистка и трансформация ключей/значений
compact, transform_keys и transform_values упрощают преобразования:
messy_data = { "firstName" => "bob", "lastName" => "smith", "age" => 30 }
clean_data = messy_data
  .transform_keys(&:to_sym)
  .transform_values { |v| v.is_a?(String) ? v.capitalize : v }
# => { firstName: "Bob", lastName: "Smith", age: 30 }
Выбор правильного инструмента
Hash гибок, но не всегда оптимален. Рассмотрите альтернативы:
- Struct — для небольших фиксированных наборов атрибутов.
- OpenStruct — для быстрого прототипирования, но с затратами по производительности.
- Set — для быстрых проверок уникальности и членства4.
Краткая сводка:
| Структура | Когда использовать | Преимущество |
|---|---|---|
| Hash | Динамичные данные ключ–значение | Максимальная гибкость |
| Struct | Фиксированные поля | Экономия памяти; методный доступ |
| OpenStruct | Прототипы и непредсказуемые ключи | Удобство использования |
| Set | Уникальность и быстрые проверки | O(1) проверка членства |
Рефакторинг с помощью Hash-паттернов
Hash отлично подходит для таблиц поиска и сокращения длинных цепочек if/elsif. Это отделяет данные от логики и облегчает добавление новых случаев.
ENDPOINTS = {
  development: "http://dev.api.example.com",
  staging: "http://staging.api.example.com",
  production: "https://api.example.com"
}.freeze

def get_api_endpoint(environment)
  ENDPOINTS.fetch(environment, "http://localhost:3000")
end
Хэши опций упрощают сигнатуры методов, объединяя опциональные параметры в один расширяемый аргумент.
Производительность и влияние в приложениях Rails
Hash повсюду в Rails: params, сессии и обработка JSON. Нееффективное создание Hash и частые копирования могут увеличить потребление памяти и замедлить отклики. Профилируйте горячие участки и по возможности используйте операции на месте или ленивые инициализации, чтобы уменьшить накладные расходы. Rails использует Hash-подобные структуры для params, так что нормализация входных данных и ранняя конвертация ключей помогают избежать ошибок и лишних преобразований5.
Часто задаваемые вопросы
Является ли Ruby Hash тем же самым, что и hashmap?
Да. Hash — это реализация хеш-таблицы в Ruby и обладает типичными характеристиками hashmap — быстрый доступ по ключу и амортизированное O(1) для основных операций1.
Какую распространённую ошибку мне следует избегать при работе с Hash?
Самая частая ошибка — смешивание Symbol и String как ключей. Нормализуйте входные данные на границе системы и придерживайтесь единого соглашения, обычно Symbol для внутренних ключей3.
Как использование Hash влияет на производительность в Rails?
Hash используется во многих местах Rails. Неоптимальные операции над Hash (частые копирования, ненужные преобразования ключей) могут привести к увеличению памяти и задержкам. Профилируйте и применяйте in-place операции, когда это безопасно5.
Краткие вопросы и ответы
Q: Как защититься от NoMethodError при обращении к вложенным ключам?
A: Используйте dig или задайте безопасные значения по умолчанию с Hash.new(default) или proc по умолчанию.
Q: Когда переходить с Hash на Struct или Set?
A: Выбирайте Struct для фиксированных полей и Set для проверок уникальности и быстрых вхождений.
Q: Как безопасно объединять конфигурации из нескольких источников?
A: Используйте недеструктивный merge и замораживайте итоговую конфигурацию. Если нужны обновления на месте, документируйте побочные эффекты при использовании merge!.
В Clean Code Guy мы помогаем командам превращать сложные кодовые базы в активы, которые легко поддерживать и масштабировать. Узнайте больше в нашем разделе по Ruby: https://cleancodeguy.com/ruby
1.
Wikipedia, “Hash table.” https://en.wikipedia.org/wiki/Hash_table
2.
Ruby Issue Tracker, “Hash improvement (power-of-two, data locality).” https://bugs.ruby-lang.org/issues/12142
3.
Ruby Guides, “Symbols in Ruby.” https://www.rubyguides.com/2019/03/ruby-symbols/
4.
Ruby Standard Library Documentation, Set. https://ruby-doc.org/stdlib-2.7.0/libdoc/set/rdoc/Set.html
5.
Rails Guides, “Parameters.” https://guides.rubyonrails.org/action_controller_overview.html#parameters
🙋🏻♂️
ИИ пишет код.Вы делаете его долговечным.
В эпоху ускорения ИИ чистый код — это не просто хорошая практика — это разница между системами, которые масштабируются, и кодовыми базами, которые рушатся под собственным весом.