Descubra como dominar o Hash em Ruby para escrever código mais claro, rápido e fácil de manter. Este guia mostra funcionamento interno, práticas idiomáticas, armadilhas e receitas práticas.
January 30, 2026 (8mo ago) — last updated September 5, 2026 (1mo ago)
Hash em Ruby: código limpo e escalável
Domine o Hash (hashmap) em Ruby: uso idiomático, desempenho, armadilhas comuns e padrões de refatoração para código mais limpo e escalável.
← Back to blog
Hash em Ruby: código limpo e escalável
Resumo: Domine o Hash (hashmap) em Ruby: uso idiomático, desempenho, armadilhas comuns e padrões de refatoração para código mais limpo e escalável.
Introdução
Descubra como dominar o Hash em Ruby para escrever código mais claro, rápido e fácil de manter. Este guia mostra como o Hash funciona por dentro, práticas idiomáticas, armadilhas comuns, receitas práticas e quando escolher alternativas mais adequadas. Ao aplicar essas técnicas você reduzirá complexidade, evitará bugs sutis e terá código mais preparado para crescer.
Por que dominar o Hash muda a forma como você programa
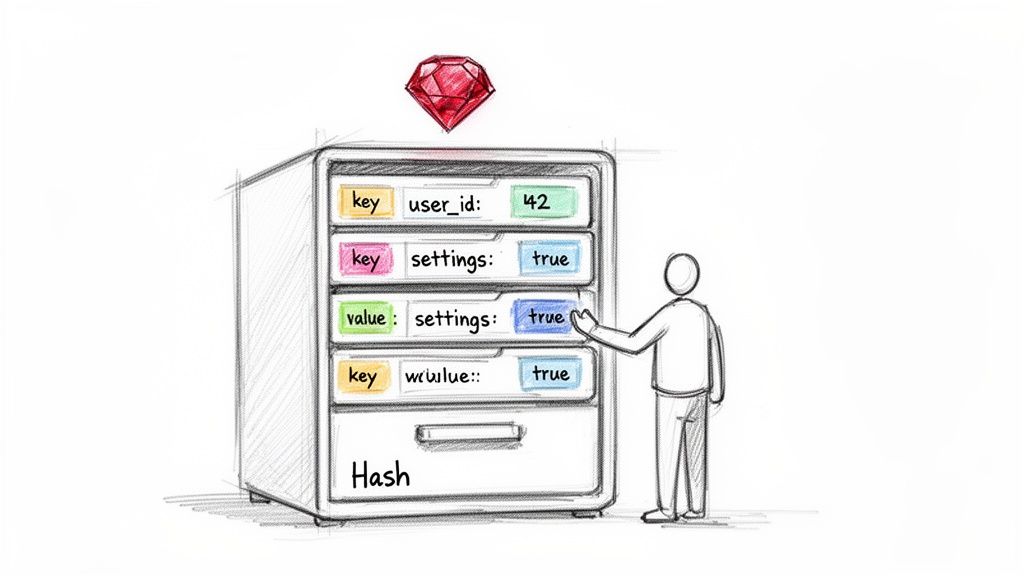
No núcleo, um Hash em Ruby é uma coleção de chaves únicas e seus valores. Pense nele como um dicionário: você busca uma palavra (a chave) para obter sua definição (o valor). Hashes são usados em parâmetros, sessões, configurações e muitos outros locais porque oferecem operações de inserção e busca em tempo próximo de constante (amortizado O(1))1.
Aprender Hashes vai além da sintaxe. Significa adotar um estilo de código mais direto: em vez de cadeias longas de if/else, muitas vezes você substitui a lógica por uma busca por chave. Isso reduz complexidade, melhora legibilidade e facilita manutenção.
Este guia explica como o Hash funciona internamente, uso idiomático e armadilhas, receitas práticas, alternativas quando o Hash não é a melhor escolha e padrões de refatoração aplicáveis hoje.
Como um Hash em Ruby funciona por dentro
Um Hash em Ruby é uma implementação em C otimizada de uma tabela de dispersão. Ao adicionar um par chave-valor, Ruby executa uma função de hash na chave para calcular um código numérico. Esse código é mapeado para um índice de bucket em um array interno, permitindo acessar diretamente a posição sem percorrer todos os elementos1.
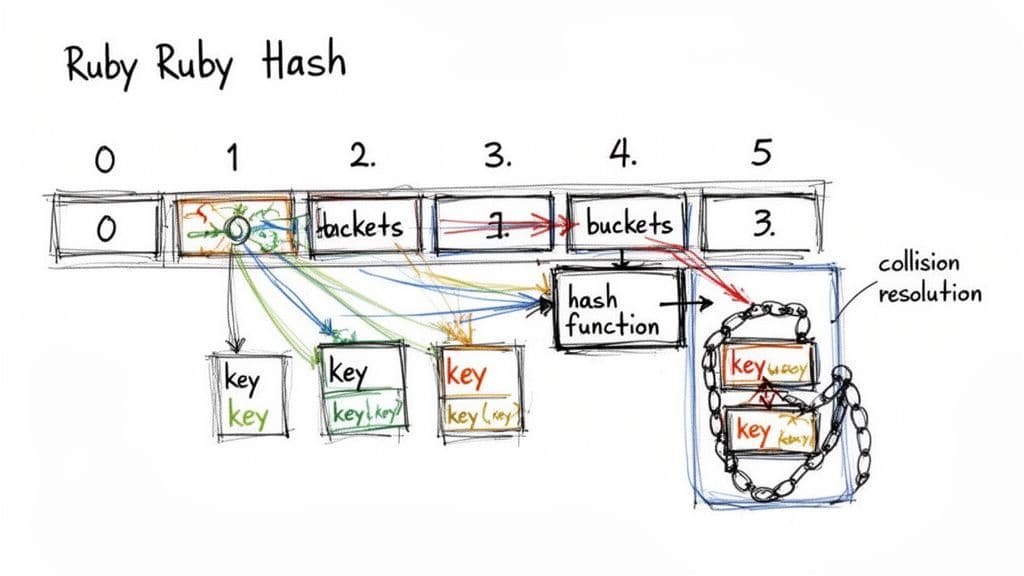
Função de hash, buckets e colisões
A função de hash reduz qualquer chave a um código numérico, que é convertido em índice de bucket. Colisões — quando duas chaves mapeiam para o mesmo índice — são normais. Ruby armazena múltiplas entradas por bucket e varre a pequena lista quando necessário. Otimizações recentes em Ruby mantêm esse percurso curto e rápido. Ruby 2.4 introduziu mudanças internas importantes que melhoraram localidade de dados e comportamento de redimensionamento, produzindo ganhos de desempenho em cenários comuns2.
Uso idiomático do Hash e armadilhas comuns
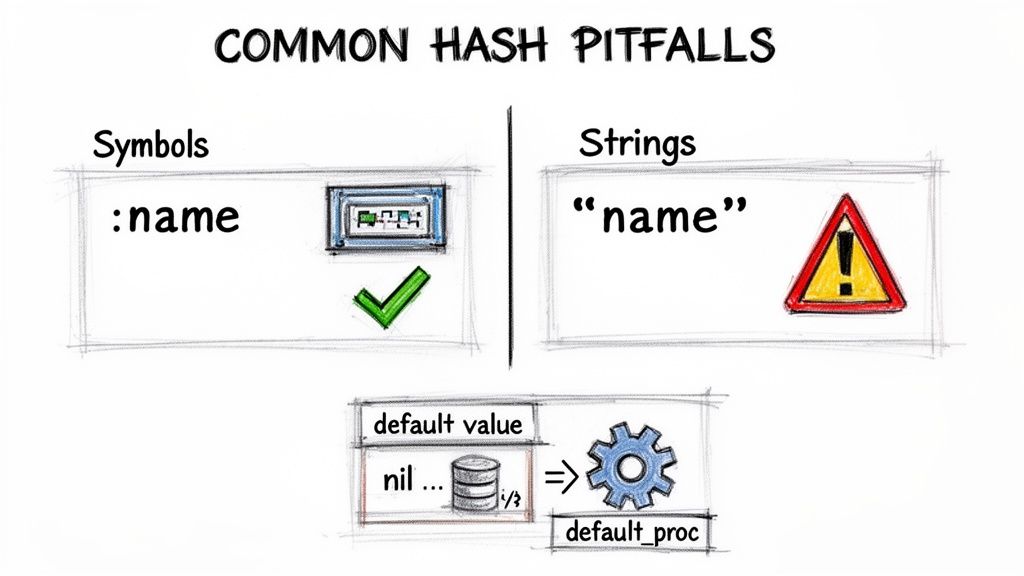
Conhecer a teoria ajuda, mas fazer Hashes funcionarem em produção exige evitar bugs sutis e escrever código previsível.
Símbolos vs Strings como chaves
Símbolos e Strings parecem semelhantes, mas se comportam de forma diferente. Um Símbolo é imutável e reaproveitado, enquanto uma String cria um novo objeto a cada uso. Símbolos são, em geral, mais rápidos e mais econômicos em memória para chaves, pois comparações podem ser feitas por identidade do objeto em vez de comparação caractere a caractere3.
Um erro comum é esperar uma chave como Símbolo quando os dados chegam como String (por exemplo, params de um request). Use convenções consistentes — converta chaves recebidas com symbolize_keys ou stringify_keys — para evitar esse desalinhamento.
Valores padrão e default procs
Acessar uma chave inexistente retorna nil, o que pode gerar NoMethodError ao chamar métodos sobre ela. Use um valor padrão para evitar surpresas:
# Safe default
fruit_counts = Hash.new(0)
fruit_counts["apple"] = 5
fruit_counts["orange"] # => 0
Para comportamento mais avançado, um default proc permite calcular ou inicializar valores de forma preguiçosa.
merge vs merge!
merge retorna um novo Hash e preserva o original. merge! muta o Hash no lugar. Prefira métodos não destrutivos quando quiser evitar efeitos colaterais e manter o fluxo de dados previsível.
Freeze para imutabilidade
Para constantes e configurações que não podem mudar, chame .freeze para prevenir mutações acidentais:
CONFIG = { api_key: "abc-123", timeout: 5000 }.freeze
# CONFIG[:timeout] = 3000 # raises FrozenError
Receita prática de Hashes em Ruby
Esta seção reúne receitas para tarefas comuns.
Iteração e transformação
Use each para iterar e select, reject, map e to_h para filtrar e transformar de forma concisa:
user_permissions = { admin: true, editor: true, viewer: false }
active_roles = user_permissions.select { |role, has_access| has_access }
role_descriptions = user_permissions.map { |role, has_access| [role, "Can perform #{role} actions: #{has_access}"] }.to_h
Navegação segura em dados aninhados com dig
dig evita NoMethodError ao atravessar hashes aninhados:
api_response = { user: { profile: { name: "Alice" } } }
email = api_response.dig(:user, :profile, :email) # => nil
name  = api_response.dig(:user, :profile, :name)  # => "Alice"
Limpeza e transformação de chaves/valores
compact, transform_keys e transform_values tornam o remodelamento e a sanitização de dados concisos e legíveis:
messy_data = { "firstName" => "bob", "lastName" => "smith", "age" => 30 }
clean_data = messy_data
  .transform_keys(&:to_sym)
  .transform_values { |v| v.is_a?(String) ? v.capitalize : v }
# => { firstName: "Bob", lastName: "Smith", age: 30 }
Escolhendo a ferramenta certa
Um Hash é flexível, mas nem sempre é a melhor escolha. Para esquemas fixos use Struct; para notação ponto com chaves imprevisíveis use OpenStruct (custo de desempenho); para checagens de unicidade use Set, que é otimizado para testes de pertencimento e construído sobre estruturas de núcleo do Ruby4.
Quando você escolhe a estrutura correta, seu código fica mais rápido, claro e fácil de manter.
Comparação rápida
| Estrutura | Melhor para | Vantagem | Observação |
|---|---|---|---|
| Hash | Dados dinâmicos chave-valor | Flexibilidade máxima | Mais memória; risco de erros de digitação |
| Struct | Conjunto pequeno e fixo de atributos | Acesso via métodos; eficiente | Inflexível |
| OpenStruct | Prototipagem, chaves imprevisíveis | Conveniência da notação ponto | Mais lento; alto uso de memória |
| Set | Checagens de unicidade rápidas | Testes de pertencimento O(1) | Sem valores associados |
Refatorando com padrões de Hash
Use Hashes para substituir longas cadeias de if/elsif ou case movendo dados para uma tabela de busca. Isso separa dados da lógica e facilita adicionar novos casos apenas incluindo uma chave.
ENDPOINTS = {
  development: "http://dev.api.example.com",
  staging: "http://staging.api.example.com",
  production: "https://api.example.com"
}.freeze

def get_api_endpoint(environment)
  ENDPOINTS.fetch(environment, "http://localhost:3000")
end
Hashes de opções também simplificam assinaturas de método, agrupando parâmetros opcionais em um único argumento extensível.
Perguntas frequentes
O Hash em Ruby é o mesmo que um hashmap?
Sim. Hashmap é o termo genérico em ciência da computação; em Ruby a classe se chama Hash e implementa uma tabela de dispersão com características de complexidade típicas da estrutura (amortizado O(1) em operações comuns)1.
Qual erro comum devo evitar com Hashes?
O erro mais frequente é misturar chaves Símbolo e String. Defina e aplique uma convenção — normalmente Símbolos para chaves internas — e normalize a entrada externa cedo no fluxo.
Como o uso do Hash afeta o desempenho em Rails?
Hashes estão presentes por toda parte em Rails: params, sessão e JSON. Criações ineficientes e operações pesadas repetidas podem inflar uso de memória e desacelerar requisições. Perfilhe os pontos críticos e prefira padrões preguiçosos ou in-place quando fizer sentido.
Perguntas rápidas (Q&A)
Q: Como evito erros de nil ao acessar chaves aninhadas?
A: Use dig ou forneça valores padrão com Hash.new(default) ou um default proc.
Q: Quando devo trocar Hash por Struct ou Set?
A: Use Struct quando os campos forem fixos e conhecidos; use Set quando precisar apenas de unicidade e testes de pertencimento rápidos.
Q: Como mesclar configurações de várias fontes com segurança?
A: Prefira merge não destrutivo e freeze no resultado final. Use merge! somente quando documentado e compreendido o efeito colateral.
No Clean Code Guy, nossa missão é ajudar equipes a transformar codebases complicadas em ativos fáceis de manter e escalar. Mergulhamos em princípios como estes para ajudá‑lo a entregar software melhor, mais rápido. Veja como podemos ajudar a construir aplicações resilientes e prontas para IA em cleancodeguy.com.
1.
Wikipedia, “Hash table.” https://en.wikipedia.org/wiki/Hash_table
2.
Ruby Issue Tracker, “Hash improvement (power-of-two, data locality).” https://bugs.ruby-lang.org/issues/12142
3.
Ruby Guides, “Symbols in Ruby.” https://www.rubyguides.com/2019/03/ruby-symbols/
4.
Ruby Standard Library Documentation, Set. https://ruby-doc.org/stdlib-2.7.0/libdoc/set/rdoc/Set.html
🙋🏻♂️
IA escreve código.Você faz durar.
Na era da aceleração da IA, código limpo não é apenas uma boa prática — é a diferença entre sistemas que escalam e bases de código que entram em colapso sob seu próprio peso.