Hash to podstawowe narzędzie w Ruby do przechowywania par klucz‑wartość. Gdy zrozumiesz, jak działa pod spodem i poznasz idiomatyczne wzorce, napiszesz prostszy, bardziej przewidywalny i szybszy kod. Ten przewodnik wyjaśnia mechanikę, typowe pułapki, praktyczne przepisy i migracje do bardziej odpowiednich struktur danych.
January 30, 2026 (7mo ago) — last updated July 31, 2026 (1mo ago)
Hash w Ruby: czysty i skalowalny kod
Naucz się używać Hash w Ruby — mechanika, wydajność, najlepsze praktyki i refaktoryzacja, by pisać czystszy i szybszy kod.
← Back to blog
Hash w Ruby: czysty i skalowalny kod
Podsumowanie: Naucz się używać Hash w Ruby — mechanika, wydajność, najlepsze praktyki i refaktoryzacja, by pisać czystszy i szybszy kod.
Wprowadzenie
Hash to podstawowe narzędzie w Ruby do przechowywania par klucz‑wartość. Gdy zrozumiesz, jak działa pod spodem i poznasz idiomatyczne wzorce, napiszesz prostszy, bardziej przewidywalny i szybszy kod. Ten przewodnik wyjaśnia mechanikę, typowe pułapki, praktyczne przepisy i migracje do bardziej odpowiednich struktur danych.
Dlaczego opanowanie Hash zmienia sposób pisania kodu
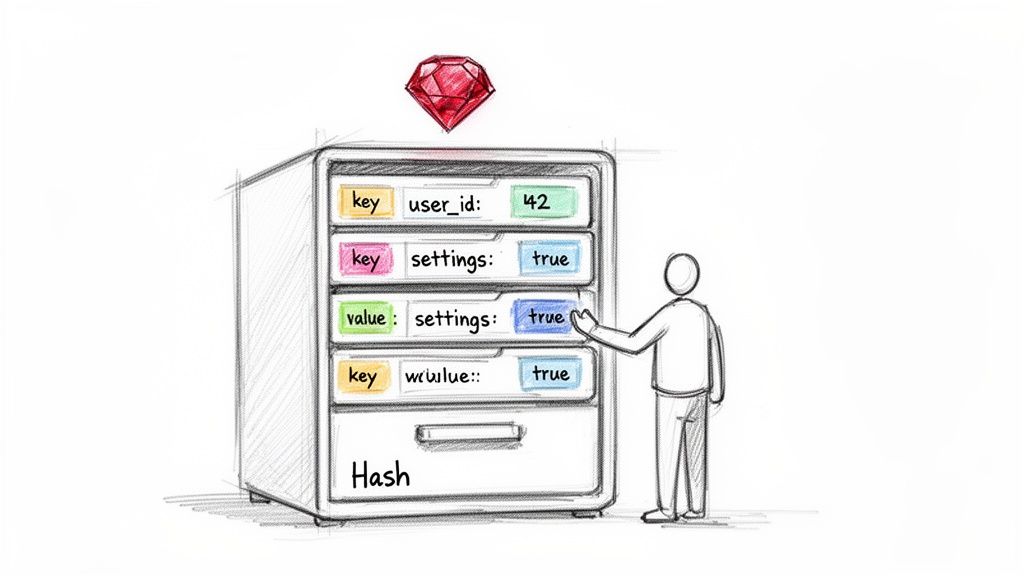
Hash w Ruby pozwala na szybki dostęp do wartości dzięki mapowaniu kluczy do indeksów w tablicy wewnętrznej — operacje wstawiania i wyszukiwania są w praktyce bliskie stałego czasu wykonania (amortized O(1))1. Zamiast rozgałęzień if/else często wystarczy prosty lookup, co obniża złożoność i poprawia czytelność kodu.
Ten artykuł przeprowadzi cię przez implementację Hash, idiomatyczne użycie, pułapki, gotowe przepisy i przykłady refaktoryzacji, które możesz wdrożyć natychmiast.
Jak działa Hash w Ruby
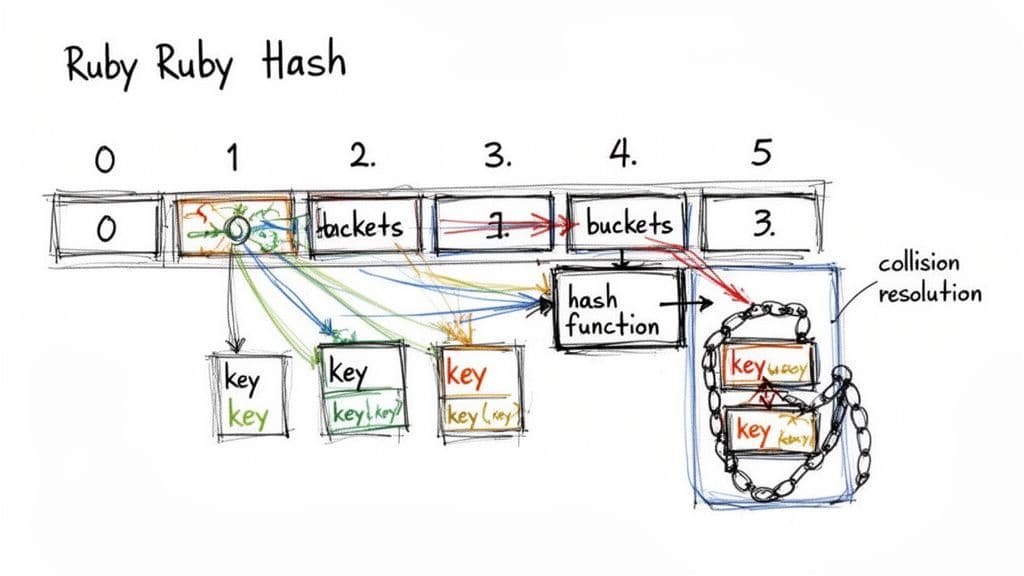
Hash jest implementacją tablicy mieszającej napisaną w C w jądrze Ruby5. Dodając parę klucz‑wartość, Ruby oblicza kod mieszający (hash code) i wyznacza indeks bucketa w wewnętrznej tablicy, dzięki czemu nie trzeba przeszukiwać wszystkich elementów po kolei.
Funkcja mieszająca, buckety i kolizje
Funkcja mieszająca redukuje klucz do liczbowego kodu, który zostaje przekonwertowany na indeks bucketa. Kolizje — gdy różne klucze trafiają do tego samego bucketa — są normalne. Ruby przechowuje wtedy kilka wpisów w tym buckecie i skanuje krótką listę w razie potrzeby. Optymalizacje w Ruby zmniejszają częstotliwość i koszt skanów, poprawiając lokalność danych i zachowanie przy zmianie rozmiaru tablicy2.
Idiomatyczne użycie Hash i typowe pułapki
Poznanie teorii to jedno — stosowanie Hash w produkcji to drugie. Oto najważniejsze wzorce i błędy, których warto unikać.
Symbol vs String jako klucze
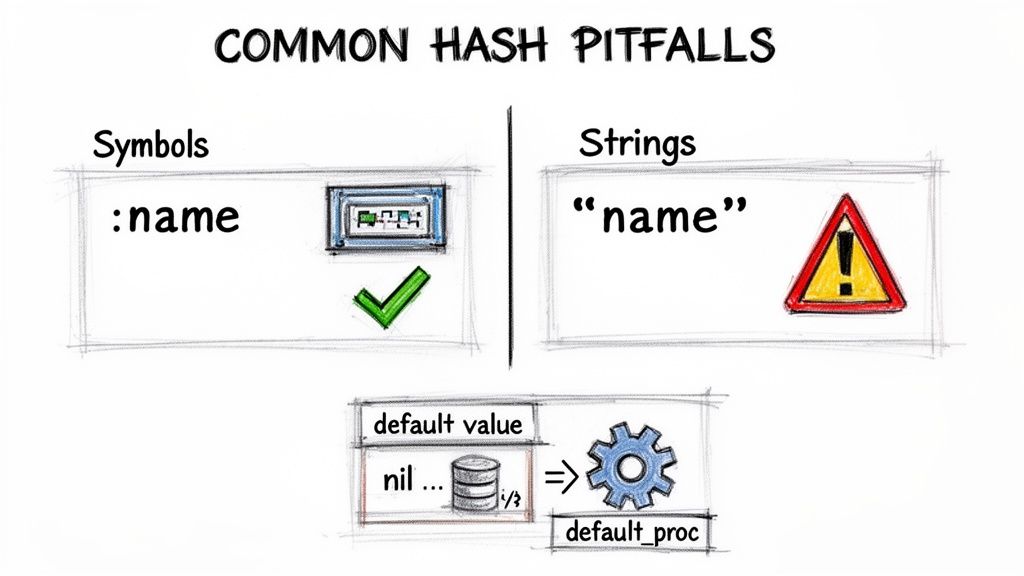
Symbol jest niemutowalny i współdzielony, a String tworzy nowy obiekt przy każdym użyciu. Symbole są zazwyczaj szybsze i bardziej oszczędne pamięciowo dla kluczy, ponieważ porównania mogą odbywać się po identyfikatorze obiektu zamiast porównywać znaki3. Częsty błąd to mieszanie Symboli i Stringów (np. przy danych z zewnątrz). Normalizuj klucze wcześnie przy wejściu, używając metod takich jak symbolize_keys lub stringify_keys.
Wartości domyślne i default proc
Dostęp do nieistniejącego klucza zwraca nil, co może prowadzić do NoMethodError przy wywoływaniu metod na nil. Użyj wartości domyślnej, aby uniknąć niespodzianek:
# Safe default
fruit_counts = Hash.new(0)
fruit_counts["apple"] = 5
fruit_counts["orange"] # => 0
Dla zaawansowanej logiki użyj default proc, który inicjalizuje wartości leniwie.
merge vs merge!
merge zwraca nowy Hash, merge! modyfikuje istniejący. Preferuj metody niedestrukcyjne, gdy chcesz uniknąć efektów ubocznych i zachować przewidywalny przepływ danych.
Freeze dla niemutowalności
Dla stałych i ustawień, które nie mogą się zmieniać, wywołaj .freeze, by zapobiec przypadkowym modyfikacjom:
CONFIG = { api_key: "abc-123", timeout: 5000 }.freeze
# CONFIG[:timeout] = 3000 # raises FrozenError
Praktyczny „cookbook” — wzorce i przepisy
Iteracja i transformacje
Używaj each do iteracji i select, reject, map oraz to_h do czystej transformacji:
user_permissions = { admin: true, editor: true, viewer: false }
active_roles = user_permissions.select { |role, has_access| has_access }
role_descriptions = user_permissions.map { |role, has_access| [role, "Can perform #{role} actions: #{has_access}"] }.to_h
Bezpieczne przechodzenie danych z dig
dig zapobiega NoMethodError przy przechodzeniu zagnieżdżonych struktur:
api_response = { user: { profile: { name: "Alice" } } }
email = api_response.dig(:user, :profile, :email) # => nil
name  = api_response.dig(:user, :profile, :name)  # => "Alice"
Czyszczenie i przekształcanie kluczy/wartości
compact, transform_keys i transform_values ułatwiają przekształcanie i sanitację danych:
messy_data = { "firstName" => "bob", "lastName" => "smith", "age" => 30 }
clean_data = messy_data
  .transform_keys(&:to_sym)
  .transform_values { |v| v.is_a?(String) ? v.capitalize : v }
# => { firstName: "Bob", lastName: "Smith", age: 30 }
Wybór właściwego narzędzia
Hash jest elastyczny, ale nie zawsze najlepszy. Dla stałych schematów użyj Struct; dla wygodnego dostępu kropkowego przy nieprzewidywalnych kluczach użyj OpenStruct (jednak pamiętaj o koszcie wydajności); dla sprawdzeń unikalności użyj Set, zoptymalizowanego pod kątem testów przynależności4.
Kiedy wybierzesz odpowiednią strukturę, kod będzie szybszy, czytelniejszy i łatwiejszy w utrzymaniu.
Krótkie porównanie
| Struktura | Najlepsze użycie | Zaleta | Uwaga |
|---|---|---|---|
| Hash | Dynamiczne pary klucz‑wartość | Maksymalna elastyczność | Większe zużycie pamięci; pomyłki w kluczach |
| Struct | Małe, stałe zestawy pól | Oszczędność pamięci; dostęp metodami | Mniej elastyczne |
| OpenStruct | Prototypowanie, nieprzewidywalne klucze | Wygodne notacja kropkowa | Wolniejsze; większe pamięciożerność |
| Set | Szybkie sprawdzanie unikalności | O(1) porównań | Brak wartości skojarzonych |
Refaktoryzacja z użyciem Hash
Zastąp długie łańcuchy if/elsif lub case tabelą lookup, by oddzielić dane od logiki i ułatwić rozbudowę:
ENDPOINTS = {
  development: "http://dev.api.example.com",
  staging: "http://staging.api.example.com",
  production: "https://api.example.com"
}.freeze

def get_api_endpoint(environment)
  ENDPOINTS.fetch(environment, "http://localhost:3000")
end
Opcjonalne argumenty w metodach możesz grupować w Hash, co upraszcza sygnatury i dodawanie nowych opcji.
FAQ — najczęściej zadawane pytania
Czy Ruby Hash to to samo co hashmap?
Tak. Hash to implementacja tablicy mieszającej (hashmap) w Ruby — daje typowe właściwości zbliżone do amortyzowanego O(1) dla operacji podstawowych1.
Jaki błąd najczęściej popełniają programiści z Hash?
Najczęściej mieszają Symbol i String jako klucze. Ustal konwencję (zazwyczaj Symbole dla kluczy wewnętrznych) i normalizuj dane wejściowe od razu.
Jak używanie Hash wpływa na wydajność Rails?
Hash są wszechobecne w Rails (params, session, JSON). Nadmierna alokacja i ciężkie operacje na Hash mogą zwiększać zużycie pamięci i czas odpowiedzi — profiluj krytyczne miejsca i stosuj wzorce leniwe lub operacje in‑place, gdy to ma sens.
Szybkie Q&A (krótkie odpowiedzi)
Q: Jak uniknąć błędów z Symbol vs String?
A: Normalizuj wejście natychmiast (np. symbolize_keys) i dokumentuj konwencję w repozytorium.
Q: Kiedy przejść z Hash na Struct albo Set?
A: Użyj Struct gdy pola są stałe i znane; Set gdy potrzebujesz tylko unikalności i szybkich testów przynależności.
Q: Jak bezpiecznie scalać konfiguracje z wielu źródeł?
A: Preferuj merge (niedestrukcyjne) i na końcu zamrażaj wynik .freeze; jeśli używasz merge!, dokumentuj efekt i testuj konflikty.
Na Clean Code Guy pomagamy zespołom przekształcać skomplikowane bazy kodu w utrzymywalne i skalowalne systemy. Zobacz więcej zasobów dotyczących Ruby i najlepszych praktyk na https://cleancodeguy.com i w naszym przewodniku Ruby: https://cleancodeguy.com/ruby-best-practices.
1.
Wikipedia, “Hash table.” https://en.wikipedia.org/wiki/Hash_table
2.
Ruby Issue Tracker, “Hash improvement (power-of-two, data locality)”. https://bugs.ruby-lang.org/issues/12142
3.
Ruby Guides, “Symbols in Ruby”. https://www.rubyguides.com/2019/03/ruby-symbols/
4.
Ruby Standard Library Documentation, Set. https://ruby-doc.org/stdlib-2.7.0/libdoc/set/rdoc/Set.html
5.
Ruby Core Documentation, Hash. https://ruby-doc.org/core-2.7.0/Hash.html
🙋🏻♂️
AI pisze kod.Ty sprawiasz, że przetrwa.
W erze przyspieszenia AI czysty kod to nie tylko dobra praktyka — to różnica między systemami, które się skalują, a bazami kodu, które zapadają się pod własnym ciężarem.