Ob Sie stabilization oder stabilisation schreiben, das Ziel ist dasselbe: verhindern, dass instabile Systeme Ihr Team ausbremsen. Dieser Leitfaden zeigt praxisnahe Maßnahmen — Stabilisation-Sprints, CI/CD-Härtung, Feature-Flags und gezieltes Refactoring — damit Sie technische Schuld reduzieren und verlässlich ausliefern.
January 31, 2026 (9mo ago) — last updated October 18, 2026 (1mo ago)
Software-Stabilisierung: Fehler beheben
Techniken zur Stabilisierung fehleranfälliger Codebasen: Stabilisation-Sprints, CI/CD-Härtung, Feature-Flags und gezieltes Refactoring.
← Back to blog
Software-Stabilisierung: Fehleranfälligen Code beheben
Entdecken Sie Stabilisierungstechniken, um fehleranfälligen Code in zuverlässige Features zu verwandeln. Praktische Strategien zur Reduzierung von Bugs und zur sicheren Auslieferung.
Einführung
Ob Sie stabilization (amerikanisches Englisch) oder stabilisation (britisches/kanadisches Englisch) schreiben, das Ziel ist dasselbe: verhindern, dass instabile Systeme Ihr Team ausbremsen. Dieser Leitfaden beschreibt praktikable Schritte wie Stabilisation-Sprints, CI/CD-Härtung, Feature-Flags, gezieltes Refactoring und Talentstrategien, damit Sie technische Schuld reduzieren, mit Vertrauen ausliefern und die Entwicklerproduktivität wiederherstellen.
Was ist Software-Stabilisation und warum sie wichtig ist
Stellen Sie sich Ihre Software als Hochleistungsrennwagen vor. Ständig neue Features hinzuzufügen, ohne Bremsen oder Fahrwerk zu prüfen, macht das Ganze irgendwann gefährlich instabil. Software-Stabilisation ist der methodische Boxenstopp, bei dem Sie das System verstärken, Ursachen der Instabilität finden und nicht nur Bugs, sondern auch Performance-Engpässe und architektonische Mängel beheben. Das Ziel ist ein Produkt, das jedes Mal robust und vorhersehbar ist.
Die Kosten der Instabilität
Ein instabiles System untergräbt Kundenvertrauen, bindet Engineering-Ressourcen und verlangsamt Innovation. Wenn Entwickler ständig Brandbekämpfung leisten, fehlen Kapazitäten für neue Features. Ein ständiger Fokus auf Auslieferung ohne Stabilisationszeit ist ein klassisches Zeichen wachsender technischer Schuld2. Dieser reaktive Kreislauf erhöht Ausfallrisiken und schadet Moral sowie Produktqualität.
Stabilisation als strategische Investition
Stabilisation ist mehr als Fehlerbehebung. Sie stellt Vertrauen in die Codebasis für Entwickler, Produktmanager und Führung zurück. Mit einer sauberen Grundlage arbeiten auch KI-Assistenztools besser, weil sie auf konsistente Muster treffen. Vorteile einer dedizierten Stabilisationsphase:
- Erhöhte Vorhersehbarkeit bei Releases
- Verbesserte Entwicklerproduktivität
- Gestärktes Nutzervertrauen
Priorisieren Sie Stabilisation als Investition in nachhaltiges Wachstum und langfristige Produktgesundheit.
Häufige Ursachen für Software-Instabilität
Instabilität schleicht sich durch hastige Entscheidungen unter Druck ein. Bevor Sie beheben, identifizieren Sie Ursachen.
Technische Schuld als Hauptursache
Unkontrollierte technische Schuld entsteht durch Abkürzungen wie übersprungene Tests oder schnelle Hacks. Diese Schulden führen zu Bugs, Performance-Problemen und langsamerer Auslieferung. Echte Stabilisation verlangt Tilgung der Schuld durch gezieltes Refactoring und befristete Behebungsarbeiten2.
Schwache oder flaky Tests
Eine unzuverlässige Test-Suite vermittelt ein falsches Sicherheitsgefühl. Flaky Tests und Lücken in der Abdeckung lassen Regressionen in Produktion rutschen, verlangsamen Feedback und hemmen Refactoring.
Eng gekoppelter Code
Stark gekoppelte Komponenten machen jede Änderung riskant. Brechen Sie Abhängigkeiten auf und schaffen Sie modulare Schnittstellen, um Änderungssicherheit und Wartbarkeit zu erhöhen.
5 praktische Muster zur Stabilisation der Codebase
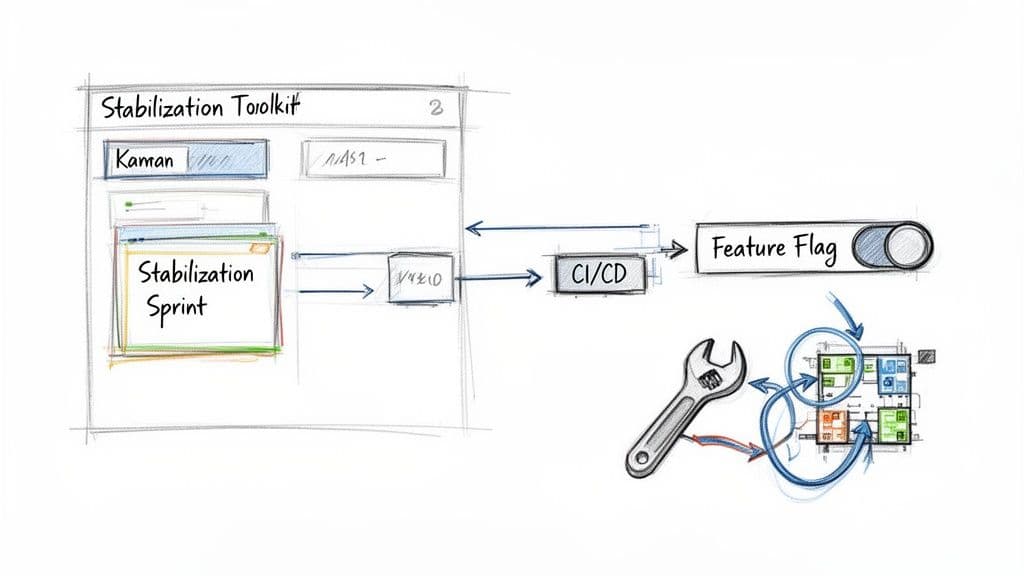
Wählen Sie das passende Muster zur richtigen Zeit. Kombiniert bilden diese Maßnahmen eine robuste Verteidigung gegen Instabilität.
1. Fokussierte Stabilisation-Sprints
Führen Sie ein- bis zweiwöchige Stabilisation-Sprints durch, in denen neue Feature-Arbeit pausiert wird und das Team Bugs, Performance-Probleme und gezielte Refactors angeht. Diese Zeit hilft, technische Schuld abzubauen und Kontrolle zurückzugewinnen.
(Interner Link: Stabilisations-Sprints)
2. CI/CD-Pipelines härten
Ihre Pipeline sollte als Qualitätsgate fungieren und bei jedem Commit statische Analyse, Sicherheitsscans und Tests ausführen. Stoppen Sie Auslieferungen bei fehlgeschlagenen Tests und messen Sie Pipeline-Erfolgsraten, um flaky Tests früh zu erkennen1.
3. Deployment und Release mit Feature-Flags entkoppeln
Feature-Flags erlauben, unfertigen Code bereitzustellen, ohne ihn freizuschalten. So reduzieren Sie Release-Risiko, verringern Merge-Konflikte und können problematische Features sofort deaktivieren.
4. Strategisches Refactoring
Refaktorieren Sie gezielt dort, wo es am meisten hilft: große God-Objekte, enge Kopplungen und Komponenten, die die Velocity blockieren. Priorisierung liefert die beste Rendite pro Aufwand.
5. Talent-Pipeline stabilisieren
Sichern Sie konsistenten Zugang zu verlässlichen Engineering-Talenten, die wartbaren Code schätzen. Regionale Märkte verändern sich, und stabile Hubs für Entwicklungspartnerschaften können langfristig helfen3.
Stabilisationsmuster im Überblick
| Pattern | Ziel | Am besten für | Aufwand |
|---|---|---|---|
| Stabilisation-Sprints | Technische Schuld abbauen | Teams mit hoher Instabilität | Mittel bis hoch |
| CI/CD-Härtung | Schlechten Code stoppen | Jedes Team mit Automatisierung | Mittel |
| Feature-Flags | Release-Risiko reduzieren | Häufige Releases | Niedrig bis Mittel |
| Strategisches Refactoring | Wartbarkeit erhöhen | Legacy-/komplexe Systeme | Hoch |
| Talent-Pipeline | Konstante Entwicklerqualität | Wachsende Teams | Variiert |
Kombinieren Sie diese Muster, um eine geschichtete Verteidigung aufzubauen.
Stabilität messen: Die richtigen Kennzahlen
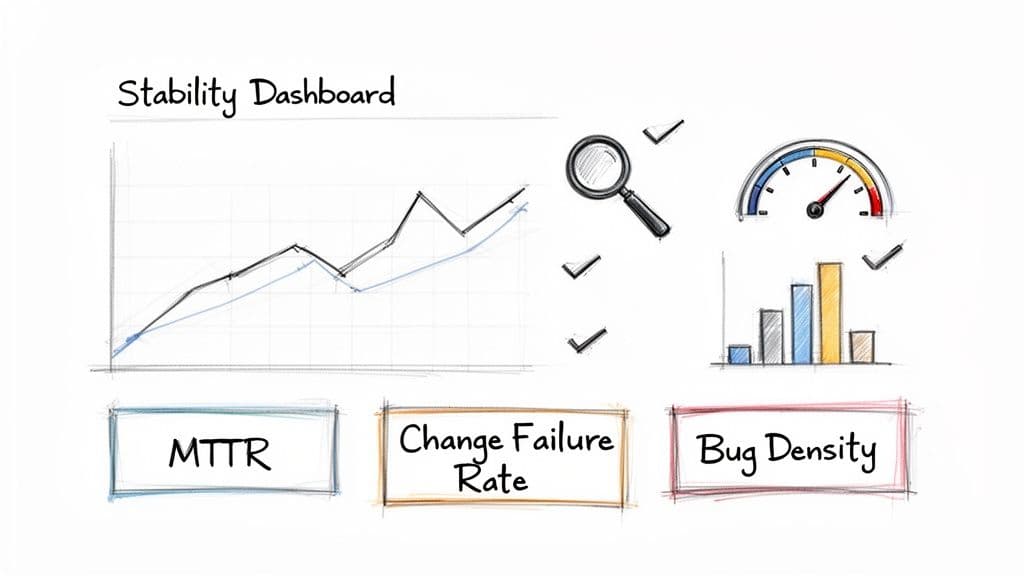
Sie können nicht verbessern, was Sie nicht messen. Nutzen Sie objektive Metriken, um Fortschritt zu verfolgen und Entscheidungen zu treffen.
Wichtige technische Indikatoren
Starten Sie mit DORA-ähnlichen Metriken: Mittlere Wiederherstellungszeit (MTTR) und Fehlerquote bei Änderungen (Change Failure Rate, CFR). MTTR misst, wie schnell Sie nach Vorfällen wiederherstellen, CFR zeigt, wie oft Deployments zu Ausfällen führen. Diese Messgrößen liefern Einblick in operative Resilienz und Release-Qualität1.
Frühindikatoren für Probleme
Verfolgen Sie Bug-Dichte und CI-Erfolgsrate, um Verschlechterungen früh zu erkennen. Steigende Bug-Dichte oder sinkende Pipeline-Erfolgsraten signalisieren bevorstehende Risiken.
Produktfokussierte Metriken
Messen Sie Stabilität aus Nutzersicht: Absturzrate und nutzerberichtete Fehler zeigen die reale Auswirkung technischer Probleme. Kombinieren Sie diese mit technischen Indikatoren, um Entwicklungsaufwand mit Nutzererfahrung zu verbinden. Investitionen in geeignete Werkzeuge reduzieren solche Probleme und unterstützen Wachstum in neuen Märkten4.
Stabilisations-Roadmap für Startups und Unternehmen
Startups und Unternehmen brauchen unterschiedliche Ansätze. Startups profitieren von leichten, wirkungsstarken Praktiken; Unternehmen setzen auf inkrementelle Modernisierung.
Startup-Roadmap: Leicht und wirkungsvoll
- Durchsetzen strikter Linter-Regeln, um Probleme früh zu erkennen.
- Einfache CI-Pipeline, die bei jedem Commit Linting und Unit-Tests ausführt.
- Unit-Tests für kritische Logik priorisieren, statt auf vollständige Coverage zu bestehen.
Enterprise-Roadmap: Inkrementelle Modernisierung
- Starten Sie mit einem Codebase-Audit, um brüchige Module zu identifizieren.
- Nutzen Sie das Strangler-Fig-Pattern, um Legacy schrittweise zu ersetzen.
- Fördern Sie Verantwortung in Teams, damit Schuld in den Domänen abgebaut wird.
Inkrementelle Veränderungen reduzieren Risiko und liefern stetige Verbesserungen.
Eine Kultur kontinuierlicher Stabilisation
Stabilität ist ein kulturelles Commitment, kein einmaliges Projekt. Nehmen Sie Stabilisation in Roadmaps auf, messen Sie Fortschritt und belohnen Sie Maßnahmen, die Risiko reduzieren. So wird kontinuierliche Stabilisation Teil der Team-DNA und ermöglicht langfristige Velocity.
Häufige Fragen zur Software-Stabilisation
Wie lange sollte ein Stabilisation-Sprint dauern?
Ein bis zwei Wochen. Zwei Wochen bei hoher technischer Schuld, eine Woche für reguläre Härtung zwischen Feature-Zyklen.
Können wir während einer Stabilisationsphase Features ausliefern?
In der Regel nicht. Ziel ist, Feature-Arbeit zu pausieren, damit sich das Team fokussieren kann. Ausnahmen erfordern strenge Überprüfung, vollständige Tests und idealerweise ein Feature-Flag.
Was ist der erste Schritt bei einem Legacy-System?
Beginnen Sie mit einem gründlichen Codebase-Audit. Es liefert Daten, um Arbeit zu priorisieren und Bereiche mit dem größten Stabilitätsgewinn zu identifizieren.
Ist Ihr Team in einer instabilen Codebasis verstrickt oder baut gerade eine Qualitätskultur auf? Clean Code Guy bietet Codebase-Cleanups, AI-Ready-Refactors und praktische Workshops, die Ihnen helfen, zuverlässige, wartbare Software auszuliefern. Finden Sie heraus, wie wir helfen können unter https://cleancodeguy.com.
Kurzes Q&A
F: Was sollten wir zuerst beheben, wenn wir Code stabilisieren?
A: Starten Sie mit einem Codebase-Audit, finden Sie brüchige Module, und schützen Sie kritische Pfade mit Tests und CI/CD-Gates.
F: Wie helfen Feature-Flags der Stabilität?
A: Sie entkoppeln Deployment vom Release, erlauben es, unfertige Features zu verbergen und problematische Funktionen sofort zu deaktivieren.
F: Wie messen wir Fortschritt?
A: Verfolgen Sie MTTR und Change Failure Rate sowie Bug-Dichte und CI-Erfolgsrate als Frühwarnzeichen.
Zusammenfassende Q&A
Wie starte ich in einer instabilen Codebasis?
Führen Sie ein Audit durch, priorisieren Sie kritische Tests und legen Sie einen ersten Stabilisation-Sprint fest.
Welche Maßnahme bringt am meisten Wirkung schnell?
CI/CD-Härtung plus strikte Tests geben schnellen Schutz vor regressiven Releases.
Wie verhindere ich, dass Instabilität zurückkehrt?
Machen Sie Stabilisation zur Routine: messen, einplanen und Verantwortung in Teams verankern.
1.
https://dora.dev — DORA-Metriken und Forschung zu Deployment-Frequenz, MTTR und Change Failure Rate.
2.
https://martinfowler.com/bliki/TechnicalDebt.html — Martin Fowler über technische Schuld und ihre langfristigen Kosten.
3.
https://www.statista.com — Markt- und Outsourcing-Daten zu regionalen Talenttrends und Entwicklungs-Hubs.
4.
https://www.statista.com/outlook/tmo/software/application-development-software/central-asia?currency=USD — Marktprognosen für Anwendungsentwicklung, referenziert im Artikel.
🙋🏻♂️
KI schreibt Code.Sie lassen ihn bestehen.
Im Zeitalter der KI-Beschleunigung ist Clean Code nicht nur gute Praxis — es ist der Unterschied zwischen Systemen, die skalieren, und Codebasen, die unter ihrem eigenen Gewicht zusammenbrechen.