Entdecken Sie, wie Sie Ruby’s Hash effizient nutzen, um klareren, schnelleren und besser skalierbaren Code zu schreiben. Dieser Leitfaden zeigt Interna, Performance-Tipps, Best Practices und praktische Refactorings.
January 30, 2026 (7mo ago) — last updated June 11, 2026 (2mo ago)
Ruby Hash meistern: Performance & Best Practices
Lernen Sie, Ruby’s Hash effizient zu nutzen: Interna, Performance-Tipps, Best Practices und Refactoring für sauberen, skalierbaren Code.
← Back to blog
Ruby Hash meistern: Interna, Performance und Best Practices
Einleitung
Entdecken Sie, wie Sie Ruby’s Hash effizient nutzen, um klareren, schnelleres und besser skalierbaren Code zu schreiben. Dieser Leitfaden zeigt Interna, Performance-Tipps, idiomatische Nutzung und konkrete Refactoring-Patterns, die Sie sofort anwenden können.
Warum das Beherrschen von Ruby’s Hash Ihren Code verändert
Ein Ruby Hash ist ein leistungsfähiger Key-Value-Store. Er funktioniert wie ein digitales Ablagesystem: Jedes Datum bekommt ein eindeutiges Etikett, sodass Sie es schnell wiederfinden. Hash-Operationen bieten in der Praxis nahe konstanter Zeit für Einfügen und Nachschlagen, was sie für viele Alltagsaufgaben ideal macht1.
Hashes sind mehr als Syntax: Sie ermöglichen klarere und kürzere Lösungen statt langer if/else-Ketten. Das reduziert Komplexität, verbessert Lesbarkeit und erleichtert Wartung.
Dieser Artikel behandelt, wie ein Hash intern arbeitet, idiomatischen Gebrauch, Fallstricke, praktische Rezepte, Alternativen und Refactoring-Patterns.
Wie ein Ruby Hash intern funktioniert
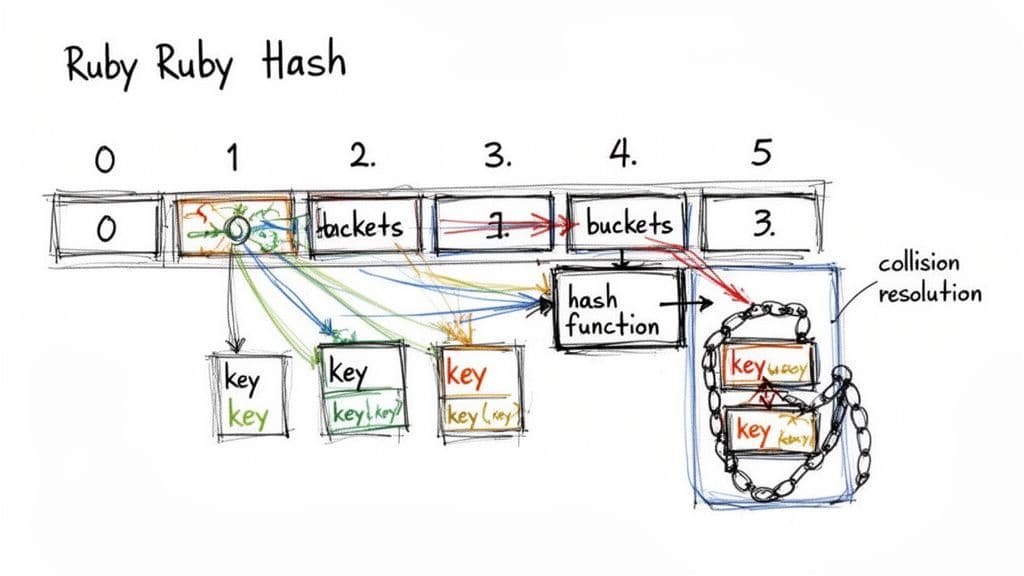
Ein Ruby Hash ist eine in C optimierte Hash-Tabelle. Beim Hinzufügen eines Schlüssel-Wert-Paars erzeugt Ruby einen Hashcode aus dem Schlüssel, der auf einen Index in einem internen Array abgebildet wird. Dadurch springt Ruby direkt zur passenden Stelle, statt alle Elemente linear zu durchsuchen1.
Hash-Funktion, Buckets und Kollisionen
Die Hash-Funktion reduziert beliebige Schlüssel zu einem numerischen Hashcode, der dann in einen Bucket-Index umgewandelt wird. Kollisionen — wenn zwei Schlüssel auf denselben Index abgebildet werden — sind normal. Ruby speichert mehrere Einträge pro Bucket und durchsucht bei Bedarf die kurze Liste. Neuere Ruby-Optimierungen halten diese Scans klein und schnell; Ruby 2.4 brachte dabei spürbare Verbesserungen durch bessere Datenlokalität und intelligentes Resizing2.
Idiomatischer Gebrauch von Hashes und häufige Fallstricke
Theorie hilft, aber in Produktion zählt Vorhersehbarkeit. Die folgenden Punkte vermeiden subtile Bugs und machen Verhalten klar.
Symbole vs. Strings als Schlüssel
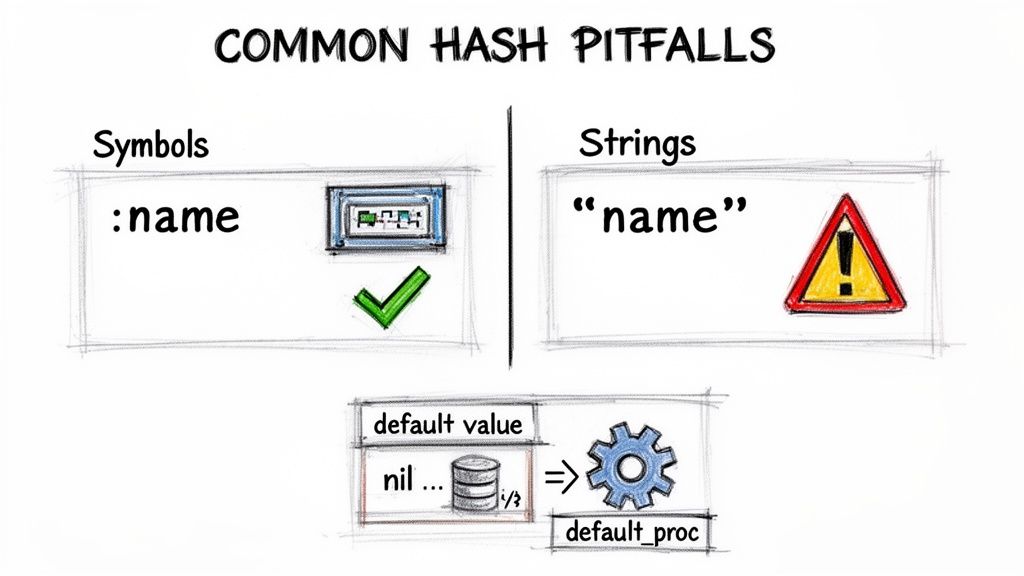
Symbole und Strings sehen ähnlich aus, verhalten sich aber anders. Ein Symbol ist unveränderlich und wird intern wiederverwendet, während bei Strings bei jeder Erstellung ein neues Objekt entstehen kann. Symbole sind in der Regel schneller und speichereffizienter für Keys, weil Vergleiche oft per Objektidentität möglich sind statt zeichenweiser Vergleiche3.
Ein häufiger Fehler ist, einen Symbol-Key zu erwarten, während die Daten String-Keys verwenden (z. B. HTTP-Parameter). Normalisieren Sie Eingaben früh mit symbolize_keys oder stringify_keys, um Missmatches zu vermeiden.
Default-Werte und Default-Procs
Beim Zugriff auf einen nicht existierenden Schlüssel liefert der Hash nil, was zu NoMethodError führen kann, wenn Sie Methoden auf dem Ergebnis aufrufen. Verwenden Sie Default-Werte oder Default-Procs:
# Sicherer Default
fruit_counts = Hash.new(0)
fruit_counts["apple"] = 5
fruit_counts["orange"] # => 0
Default-Procs erlauben eine lazy Initialisierung oder Berechnung von Werten.
merge vs. merge!
merge gibt einen neuen Hash zurück und erhält das Original. merge! verändert den existierenden Hash. Bevorzugen Sie nicht-destruktive Methoden, wenn Sie Seiteneffekte vermeiden und den Datenfluss vorhersagbar halten wollen.
Freeze zur Unveränderlichkeit
Für Konstanten und Einstellungen, die nicht verändert werden dürfen, verwenden Sie .freeze, um versehentliche Mutationen zu verhindern:
CONFIG = { api_key: "abc-123", timeout: 5000 }.freeze
# CONFIG[:timeout] = 3000 # raises FrozenError
Praktische Rezepte für den Alltag
Hier sind gebräuchliche Aufgaben und wie Sie sie mit Hashes sauber lösen.
Iteration und Transformation
Nutzen Sie each zum Durchlaufen und select, reject, map mit to_h zum Filtern und Transformieren:
user_permissions = { admin: true, editor: true, viewer: false }
active_roles = user_permissions.select { |role, has_access| has_access }
role_descriptions = user_permissions.map { |role, has_access| [role, "Can perform #{role} actions: #{has_access}"] }.to_h
Sicher durch verschachtelte Daten navigieren mit dig
dig verhindert NoMethodError beim Zugriff auf tief verschachtelte Hashes:
api_response = { user: { profile: { name: "Alice" } } }
email = api_response.dig(:user, :profile, :email) # => nil
name  = api_response.dig(:user, :profile, :name)  # => "Alice"
Keys und Werte bereinigen oder umformen
compact, transform_keys und transform_values machen Datenaufbereitung lesbar:
messy_data = { "firstName" => "bob", "lastName" => "smith", "age" => 30 }
clean_data = messy_data
  .transform_keys(&:to_sym)
  .transform_values { |v| v.is_a?(String) ? v.capitalize : v }
# => { firstName: "Bob", lastName: "Smith", age: 30 }
Das richtige Werkzeug wählen
Ein Hash ist flexibel, aber nicht immer optimal. Für feste Schemata verwenden Sie Struct; für dot-Notation mit unvorhersehbaren Keys OpenStruct (mit Performance-Kosten); für Eindeutigkeitsprüfungen Set — optimiert für Membership-Tests und auf Ruby-Core-Strukturen aufgebaut4.
Wenn Sie die passende Struktur wählen, wird Ihr Code schneller, klarer und einfacher zu warten. Weitere Artikel zu Performance-Optimierung und Refactoring finden Sie auf unserer Seite: Clean Code Guy – Ruby Performance und Clean Code Guy – Refactoring Patterns.
Kurzvergleich
| Struktur | Beste Verwendung | Vorteil | Zu bedenken |
|---|---|---|---|
| Hash | Dynamische Key-Value-Daten | Maximale Flexibilität | Höherer Speicherbedarf; Tippfehler bei Keys |
| Struct | Kleine, feste Attributssets | Speicher- und Methoden-Zugriff | Unflexibel |
| OpenStruct | Prototyping, unvorhersehbare Keys | Dot-Notation | Langsamer; hoher Speicher |
| Set | Schnelle Eindeutigkeitsprüfungen | O(1) Membership-Tests | Keine zugehörigen Werte |
Refactoring mit Hash-Patterns
Ersetzen Sie lange if/elsif- oder case-Ketten durch Lookup-Tabellen. Das trennt Daten von Logik und macht das Hinzufügen neuer Fälle so einfach wie einen neuen Schlüssel.
ENDPOINTS = {
  development: "http://dev.api.example.com",
  staging: "http://staging.api.example.com",
  production: "https://api.example.com"
}.freeze

def get_api_endpoint(environment)
  ENDPOINTS.fetch(environment, "http://localhost:3000")
end
Options-Hashes vereinfachen außerdem Methoden-Signaturen, indem optionale Parameter in ein einziges, erweiterbares Argument gebündelt werden.
Häufige Fragen (FAQ)
Ist ein Ruby Hash dasselbe wie eine Hashmap?
Ja. Hashmap ist der generische CS-Begriff; in Ruby heißt die Klasse Hash und sie implementiert die typischen Eigenschaften einer Hash-Tabelle, inklusive der erwarteten Zeitkomplexität für Einfügen und Nachschlagen1.
Welcher Fehler tritt am häufigsten bei Hashes auf?
Das häufigste Problem ist das Vermischen von Symbol- und String-Keys. Legen Sie eine Konvention fest — meist Symbole für interne Keys — und normalisieren Sie externe Eingaben früh.
Wie beeinflusst Hash-Nutzung die Performance in Rails?
Hashes sind in Rails allgegenwärtig: params, Session-Daten und JSON-Handling. Ineffiziente Hash-Erzeugung oder wiederholte teure Operationen können Speicher und Anfragen verlangsamen. Profilen Sie Hotspots und bevorzugen Sie in-place- oder Lazy-Patterns, wenn sinnvoll.
Kurze Fragen & Antworten
Q: Wie vermeide ich nil-Fehler beim Zugriff auf verschachtelte Keys?
A: Verwenden Sie dig oder Default-Werte/Default-Procs wie Hash.new(default).
Q: Wann wechsle ich von Hash zu Struct oder Set?
A: Nutzen Sie Struct, wenn Felder fix und bekannt sind; nutzen Sie Set, wenn nur Eindeutigkeit und schnelle Membership-Tests benötigt werden.
Q: Wie merge ich Konfigurationen sicher aus mehreren Quellen?
A: Bevorzugen Sie nicht-destruktives merge und frieren Sie das finale Config-Objekt mit .freeze. Verwenden Sie merge! nur, wenn Seiteneffekte dokumentiert sind.
Bei Clean Code Guy helfen wir Teams, komplexe Codebasen in wartbare, skalierbare Assets zu verwandeln. Wir vertiefen Prinzipien wie diese, damit Sie schneller bessere Software ausliefern. Erfahren Sie, wie wir Ihnen beim Aufbau einer resilienten, AI-ready Anwendung helfen können: cleancodeguy.com.
1.
Wikipedia, “Hash table.” https://en.wikipedia.org/wiki/Hash_table
2.
Ruby Issue Tracker, “Hash improvement (power-of-two, data locality).” https://bugs.ruby-lang.org/issues/12142
3.
Ruby Guides, “Symbols in Ruby.” https://www.rubyguides.com/2019/03/ruby-symbols/
4.
Ruby Standard Library Documentation, Set. https://ruby-doc.org/stdlib-2.7.0/libdoc/set/rdoc/Set.html
🙋🏻♂️
KI schreibt Code.Sie lassen ihn bestehen.
Im Zeitalter der KI-Beschleunigung ist Clean Code nicht nur gute Praxis — es ist der Unterschied zwischen Systemen, die skalieren, und Codebasen, die unter ihrem eigenen Gewicht zusammenbrechen.